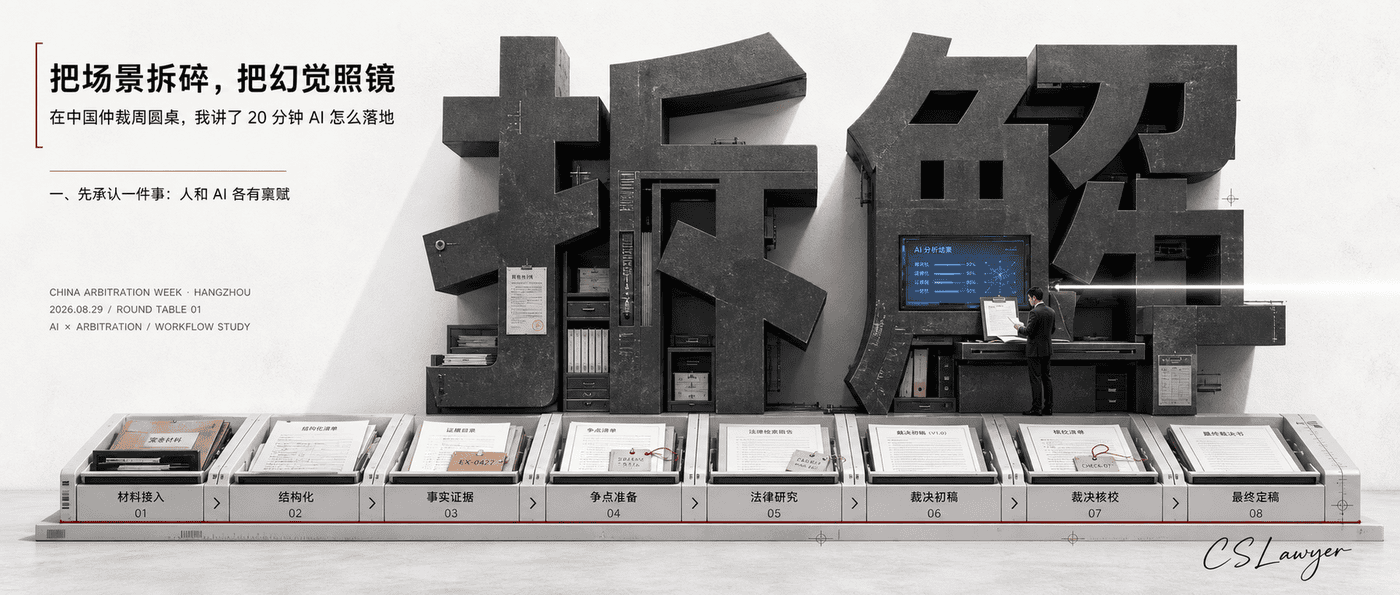
8 月 29 日下午,杭州世贸君澜大饭店。《钱江潮涌 仲智成城》,中国仲裁周炜衡杭州专题研讨会的圆桌一,主题是“仲裁与人工智能”。
轮到我的时候,主持人的问题很直接:前面几位嘉宾讲了理论与前沿,大家更想知道的恐怕是,到底怎么把 AI 落地到一个仲裁员的日常工作流里?
这个问题我正好能答。白天我在律所办案,AI 的嵌入度比较高,这一年半一直是高强度使用;晚上我办了一个线上公益班,专门教法律人用 AI、树立正确的 Agent 观念,每期带两个月,今年陆陆续续讲了大半年。一边倒逼自己研究,一边在真实案件里实践,踩过的坑和摸出来的路都算新鲜。
那天我讲了大约二十分钟。趁记忆还热,把核心内容整理成这篇文章。
一、先承认一件事:人和 AI 各有禀赋
上世纪八十年代有个理论,叫莫拉维克悖论(Moravec's Paradox)。它讲了一个反直觉的观察:对人类来说费脑力的活,推理、批量计算,机器做起来很容易;而对人类来说毫不费力的活,感知环境、拿起一件东西、走路时的条件反射,机器反而极难。
你不需要碰过所有的东西,但碰到任何一样东西的那一刻,手上的力度自然就对了:拿得起来,不会捏碎。这种迁移能力人类天生就有,机器人至今很难学会。
放到法律工作里,这个悖论的结论很朴素:人和 AI 各有禀赋。真正的问题从来不是“AI 能不能替代我”,而是“在我的工作流程里,哪些环节它的禀赋占优,哪些环节我的禀赋占优”。
要回答这个问题,得先把工作流程摊开。
二、把场景拆碎,问题才有答案
这次圆桌有个细节我很喜欢:主办方把“从案件材料到仲裁裁决”的整个过程拆成了八个环节,材料接入、分类结构化、事实证据整理、争点准备、法律研究、裁决初稿、裁决核校、最终定稿,做成背景框架贯穿全场。
这是一个非常有意义的动作。任何一个工作场景,如果只是笼统地问“这个场景该不该交给 AI”,讨论不会有结果。场景必须拆开。拆开之后你会发现,每个环节都有具体的任务、质量标准和检验方法。“AI 能做什么、人该守什么”,才从一句口号变成一张可以逐行核对的清单。
拆开之后,禀赋分布就清楚了。
有些事 AI 天然强。比如大批量资料的统计分析,只要数据真的进了智能体,它在批量处理上的优势是碾压级的,不要想着去和它竞争。再比如发散性的路径寻找。你可以试一下:面前放一瓶矿泉水,问口袋里任何一个 AI,“用这瓶矿泉水帮我设计一个二十人团建的小游戏”,它可以不停地给你出新方案,一个人做不到这个速度。但反过来,哪个版本的游戏对你想达成的目标有意义,这个判断还是你的。
有些事 AI 至今做不好。法律场景里最典型的是三件:事实的检验、从事实到法律规范的涵摄(把具体案情套进法律要件的那个推理动作),以及最后的签字。往后看相当长一段时间,这三件事大概率还是做不了。这不是技术不够努力,是禀赋不在这。
顺带澄清一个常见误解:OCR(光学字符识别)这类技术是 AI 之前的旧技术,不要算进这一代 AI 的能力。这一代生成式 AI 的本质是基于概率的数学算法,预测下一个 token(词元),生成下一个词,如此往复。它在“生成看起来像答案的东西”,不是在“计算答案”。
三、模型已经够用了,缺的是缰绳
聊 AI 的时候,大家的注意力总在模型上:哪个最强、什么时候发新版。但到了今天这个时点,模型对大多数法律场景已经够用了。不只是中美两国的头部模型,甚至千问 27B 这个量级的小模型,支撑很多法律工作都绰绰有余。
真正拉开差距的,是怎么用这个模型。
专业领域现在有个概念:一个智能体(Agent),由两部分构成,模型(Model),加上驾驭系统(Harness)。模型是那匹马,人人领到的马都差不多;Harness 是缰绳,它决定这匹马朝哪个方向走、按什么规矩走。同一个模型,驾驭得好和驾驭得不好,产出差异大得惊人。
这就是为什么我说:你用哪个 AI 工具,已经没有那么重要了。只要你用的是 Agent 形态,豆包、Kimi 这类大厂产品都有智能体模式,基础的扩展能力都在。核心价值不在选型,在持续地用。
四、法律人最爱的两个场景,恰恰最危险
说到“用”,有个体感可能要泼冷水。
你问法律人把 AI 用在什么场景,答案永远跑不掉两个:法律检索、合同审核。就我个人而言,这两个恰恰是最危险的场景。
危险在哪?拿法律检索说:如果你的模型不能接入权威信源,它就会到公开互联网上采集资料,再把采到的东西总结成答案交给你。你想想,这个总结的基础信源是今日头条,是各类自媒体,这样垒出来的“检索结论”,可靠性有多大?
但这不是说 AI 在法律检索里没用。用对了,它是增值的。原来你检索类案,人力所及大概能细看二十个、三十个,从里面找规律;今天你可以从权威信源拿两百个、三百个类案,让 AI 做批量分析。这样用,可靠性有了。效率之外,还有质量上的提升:百倍样本量跑出来的规律,会更稳。
同样的工具,两种用法,一种是给自己埋雷,一种是给自己加装备。差别只在信源。
五、幽灵规章:幻觉到底是谁的幻觉
聊 AI 绕不开幻觉。但幻觉这个话题,也得拆细了才有意思。
我在台上先问了一个问题:各位还记不记得一部“幽灵规章”,《印章管理办法》?台下不少人点头。从 2019 年起的好几年里,它在各类裁判文书中被当作正式规章反复引用,直到公安部门明确答复:这个规章从未出台。
第一个引用它的人为什么会犯错?很可能只是检索到一个类案,类案里援引了这个规章。他一眼看过去,格式规整、名称正经,“我们国家怎么可能没有一部《印章管理办法》呢?”于是顺手用进了自己的文书,没有去权威数据源核验。后面的每一批引用者,走的都是同一条路:别人都引用了,那它应该是真的。
把这个过程,和“大模型产出了内容,你看它逻辑清晰、像那么回事,就信了”放在一起看,底层逻辑有什么区别?
没有区别。
再往深一层:AI 生成的正确案例和错误案例,用的是同一套架构、同一种算法。与你的预期不匹配的,你叫它“幻觉”;匹配的,你叫它“答案”。而抛开 AI 不谈,人类历史上的幻觉也一直存在。
那当年《印章管理办法》是怎么被终结的?一个更权威的信源站出来说:没有这个东西。大家很小心地查了查,原来真没有。问题解决。
这个解法用到今天 AI 身上,一个字都不用改:管它正确的案例还是错误的案例,一律回权威源核验。别信语气,信源。(“到底是 AI 的幻觉,还是我们的幻觉”,这里面还有些更锋利的东西,我会单独写一篇。)
六、人在环中,最小作业单元
幻觉、保密这些话题拆细之后,会落到同一个结构性结论:不要幻想“人在环外”的自动化,把案件从头丢进去,等 AI 给你一个完美结果。这不符合逻辑,相当长时间内都不会符合。
符合逻辑的做法是:把场景拆碎,逐个环节看哪里 AI 现在做不好、需要人介入,把人钉在那里。这就是“人在环中”(Human-in-the-Loop)。人机协作说起来是个大词,落到日常工作里,就是一张钉人的位置图。
所以未来法律人的专业最小作业单元,可能就不再是“某律师”,而是“某律师 + 某律师的 AI”。其实,它今天就已经是这样了。
七、怎么开始:两步
那到底怎么开始?我说两步。
第一步,扔掉聊天机器人(Chatbot)的用法。豆包、Kimi 这类产品,界面上都有“聊天”和“工作”两个入口,用工作那个。在你理解的前提下,给它访问你电脑的权限。它要读你的文件、跑你的流程,权限就是它的手。
第二步,一个笨办法:遇到工作里的事,判断不了是你做得好还是它做得好,就让它做。它做完之后,怀疑它。你自己按传统方法再做一遍,两相对照,然后反馈给它:哪里不行,我的标准是什么。现在的 Agent 都有记忆机制,你告诉它的经验,它会拿小本本记下来,下次做同类工作先翻一遍小本本。
你会看到它一开始做得真不好。但会越来越好。
八、你的经验,是被它的错误勾出来的
“越来越好”是怎么发生的?这是整个落地过程里,我觉得最值得说的一件事。
每个法律人都有十几年、几十年攒下的专业判断,行话叫默会知识(Tacit Knowledge)。你可以试着把自己这些年的经验、直觉、判断标准写出来,发给任何人看。写不出来。没有人能写出来。
但它并不是真的写不出来,只是没有机会被勾出来。
勾它的机会,就藏在上一步的笨办法里。就像你带助理:助理犯了一个错,你扫一眼就知道这里不对、应该怎么改。可在这个错误出现之前,让你凭空把这条判断写出来,你硬想是想不出来的。经验是被具体的错误勾出来的。
AI 就是那个会犯一万个错、永远不累、每一次都认真听你纠正的助理。交互的频率足够高、时间足够长,你身上大量的默会知识会被一个个错误勾出来,变成显性规则,沉淀进你的工作流。它在这个场景里,就变得越来越好用。
九、把皮撕掉看一眼
用到一定深度,还有一件值得做的事:把皮撕掉。
你给智能体加载一个“仲裁专家”的技能(Skill)、接上某个工具协议(MCP),它写出来的裁决书突然有模有样了。为什么?是因为它的名字叫“仲裁专家”吗?肯定不是。是这块皮下面写着一份规则,它怎么分析一个仲裁案件、每一步判断什么、最后怎么总结。
这份规则是可以打开看的。看懂之后你多半会发现:有几处,它写得不如我。那就可以改它、升级它。等你动手改的那一刻,你就看到了实质,从“用工具的人”变成了“写规则的人”。也是从那一刻起,你开始有了一个真正跟你组队的 AI 伙伴,你们俩构成一个作业单元。
十、出厂即半成品
回到开头那个问题:AI 怎么落地?
今天所有的 AI 产品,交到你手上的那一刻,都是半成品。它变成成品,需要加上你:加你的数据、你的场景、你被一个个错误勾出来的规则。加上你,它才是成品,才有落到你的工作场景里的能力。
同样的智能体,同样的工具,同一个案子在他那里跑,结论很差;在你这里跑,结论很优秀。这跟软件已经没有关系了。你的高质量数据、你沉淀下来的规则,才是核心资产。不公开的话,它仍然是你的私产。
所以如果你还在观望、还在听各种理念,那天在圆桌上我也是这么说的:你得上手,听再多的理念都没有用。从扔掉聊天框、让它做一遍你再做一遍开始。三个月后,你手上会多一个真正属于你的成品。
作者简介: 陈石律师(主页 chenshi.ai),浙江海泰律师事务所副主任、高级合伙人、房地产与建设工程部主任,宁波市律师协会副秘书长、第七届宁波仲裁委员会仲裁员,聚焦建筑房地产、投融资、并购重组及商事争议解决。曾获多家法律媒体与专业机构认可,荣登 LegalOne 2025 中国区建工及房地产实务先锋 45 强、律新社 2025 年度管理合伙人 20 佳(华东),入选《商法》The A-List 法律精英,获评 ALB China 区域市场十五佳长三角地区律师新星,并获律新社 2024 年度并购领域品牌之星。长期为万科、华润置地、信达地产、保利置业、招商蛇口、中海地产等企业提供法律服务,承办“首宗百亿地王”“长春第一高楼”“台州第一高楼”等代表性项目,累计服务项目投资额超千亿。近年来持续推动 AI 与法律实务融合,强调以结构化方法打通技术逻辑、法律判断与商业场景;著有《赋能法律人:AI 底层思维与应用范式》,并在多地开展相关主题讲座与分享。