在各类法律科技产品推介和销售的路演中,有一句话大家一定听得耳朵都起茧子了:
“陈主任,我们这款法律大模型产品,全量接入了千万级的法律法规库和过亿篇全国裁判文书,能确保您在做每一个疑难案件分析时,检索最全、引法条最准、案例支撑最强。”
很多律所管委会或者合伙人一听到“全量”“过亿”这种宏大词汇,下意识就会觉得心里踏实,觉得花这笔采购费物超所值。
但我今天想从技术工程的底层逻辑和诉讼实战的真实体感两个维度,跟各位同行说句大实话:
在 Agent 时代,所谓“靠全量法律数据库就能办好案”,不仅在工程上是个不切实际的伪命题,在实务中甚至往往是制造严重幻觉与干扰的万恶之源。
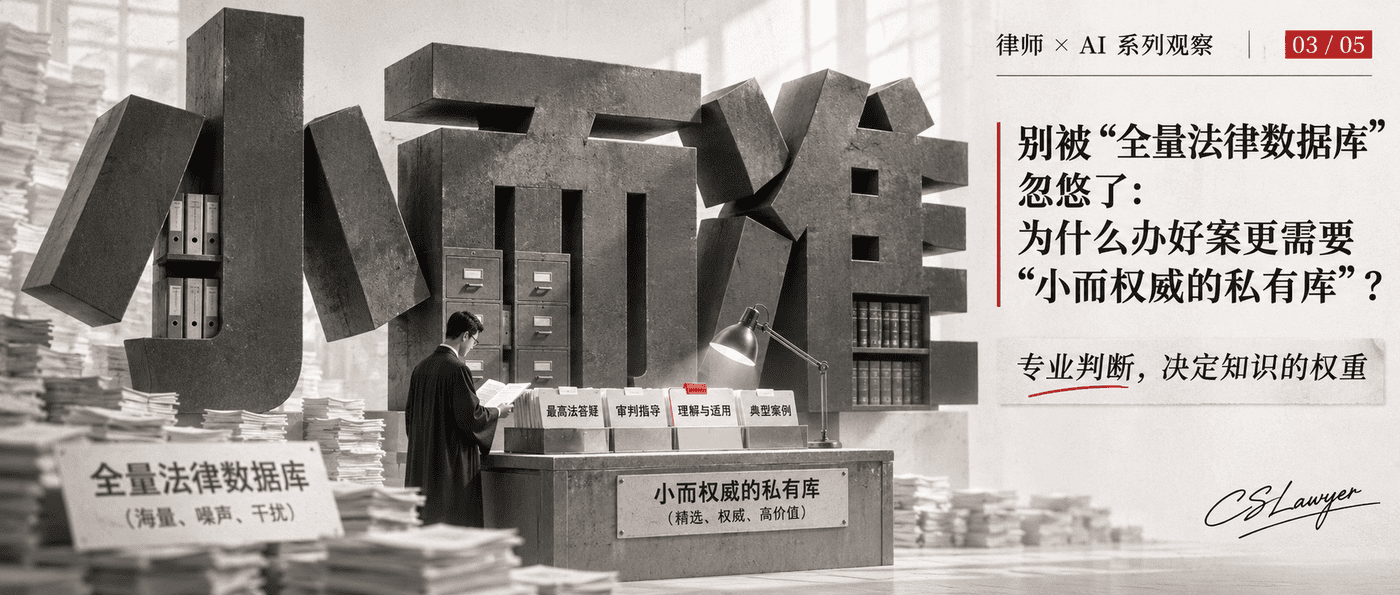
真正能拉开办案质量差距的,从来不是谁占有的数据库更大,而是谁手里掌握着一个“小而权威”的私有专业数据底座。
一、大模型的工程真相:它根本吃不下“全量”
为什么说“全量接入”在工程上是个伪命题?
我们必须先回归到大模型的工作原理。大模型不是一个把所有文件提前塞在脑子里随时调取的硬盘。现在的生成式 AI,本质上是在一条纸带上做词语接龙,基于注意力机制对下一个 Token 进行概率预测。
每一次你向它发起任务,它能够调用的资源都会面临三个极其残酷的工程物理刚性约束:上下文窗口大小(Context Window)、Token 计算成本以及网络传输延迟。
试想一下,当你在一个真实案件里调用工具时,后台实际发生了什么?
假设你正在处理一起复杂的股权回购争议,案情涉及目标公司未完成减资程序即由股东履行回购承诺的有效性问题。你让 Agent 去做案例检索。
大模型先根据你的案情提炼出两三个关键词:“对赌协议”、“定向减资”、“债权人保护”。然后,通过接口(比如 MCP 协议)一头扎进那个号称包含千万篇判决的“全量数据库”里去搜。
在这样庞大的数据库里,光是包含“减资”和“股权回购”的判决书,一搜可能就有数万篇。
重点来了:大模型会把这几万篇判决书全文都读一遍,再为你做归纳分析吗?
绝对不可能。
任何一个商业大模型,都不可能在一次对话里吃下几万篇判决书的上下文。哪怕窗口塞得下,光是处理这些文本的数据传输费用和耗时,在商业和时间上就是完全不可承受的。
所以,工程上的真实做法只能是“检索截断”:
后台的检索模块会基于关键词的向量相似度,从茫茫大海里挑出它认为“最匹配”的 10 篇或者 20 篇摘要,作为一段上下文,强行塞给大模型去消化。
问题恰恰出在这截断出来的 20 篇上:
- 数据库越庞大、越全量,泥沙俱下的无效数据、事实前提千差万别的低质基层判决就越多;
- 这种纯粹基于字面关键词的匹配,往往充斥着机械匹配的噪声;
- 这截断出来的 20 篇,极大概率不仅没能反映前沿的裁判精髓,反而刚好错过了真正决定你案件胜败的关键法理。
大模型吞下了这 20 篇充满噪声的上下文,在后续的词语接龙里,它的概率预测就被严重带偏了。它会煞有介事地总结出一套看似详实实则漏洞百出的法律意见。
大库不但没有带来精准,反而稀释了大模型宝贵的注意力资源。
二、内行与外行的认知鸿沟:外行搜泛法条,内行看微尺度
造成这种营销噱头的根源,在于技术研发人员与一线办案律师之间,存在着一道深不见底的行业认知鸿沟。
你如果去问一个互联网大厂的工程师或者初涉法律科技的产品经理:“怎么才能帮律师写出高水平的法律文书?”
他们的直觉通常非常朴素:
- “法条得全,从宪法到地方规章一个都不能漏;”
- “判决书得全,全国各级法院从一审到再审全要爬下来。”
但凡在法庭上打过硬仗的资深律师,心里都跟明镜似的:在疑难复杂商事案件中,法条往往只是骨架,裁判尺度才是血肉。
法条是公开的,任何人只要打开浏览器都能免费查到《民法典》第五百七十七条在讲什么。但是:
- 当一个具体的违约行为发生时,在当地法院的裁判尺度下,违约金过高调减的举证责任到底怎么分配?
- 所谓的“不可抗力”或“情势变更”,在特定行业产业链受冲击的背景下,审判庭认定的事实构成要件到底苛刻到了什么程度?
- 最高人民法院民二庭在最新的业务答疑中,对这类未办理审批手续的股权转让合同效力,究竟倾向于认定为未生效还是不生效?
这些真正能决定诉讼生死、决定交易成败的关键尺度,在那个几千万篇的“全量裁判库”里,往往占比不到万分之一。
外行只知道去全网捞案例,而专业律师的核心资产,恰恰聚焦在一批“维度极窄、权威度极高”的特殊知识源上:
- 最高人民法院各审判庭编著的《理解与适用》丛书:这是司法解释起草者最直接的说理意图呈现;
- “法答网”精选问答与最高法业务指导意见:这是各级法院法官在司法实践中最高频遇到的疑难卡点统一答疑;
- 《全国法院民商事审判工作会议纪要》(九民纪要)等标志性会议成果:它甚至比很多单项条文更直接地支配着商事审判逻辑;
- 特定省份高院针对建工、破产、公司纠纷发布的裁判指引与解答口径。
这些材料加在一起,字数可能也就几百万字,体积远不如“全量库”的千分之一。但它们对具体裁判者的约束力和说服力,抵得上一万篇普通判决书的胡乱堆砌。
把精力浪费在海量全库的碰运气上,是外行的打法;把精准权威的尺度提炼为核心上下文,才是内行的本事。
三、破局之道:小而专的私有知识库 + MCP 动态核验
那么,在真实的实务工程中,一个成熟的法律 Agent 应该如何科学地使用数据?
我们在实践中跑通的方法,总结起来就是一句话:大模型负责推理,私有库负责导向,外部数据库负责确证。
1. 打造“小而精”的垂直私有库
专业律师不要指望一个通用数据库解决所有问题。
做建筑房地产的,就围绕工程款优先受偿权、挂靠施工责任、工期延误索赔这几个核心争点,梳理一份几十万字的私有高价值语料库;做投融资并购的,就专门收集最高法关于对赌协议履行、股权转让违约金调整的前沿实务综述。
把这些经过你亲自甄别、高度信赖的权威观点,直接放入工作区的知识层(Knowledge Base)。当 Agent 开始起草文书时,它引用的先验知识完全处于高纯度、高确信度的轨道上,彻底杜绝了泛泛大库带来的截断噪声。
2. 用 MCP 把外部大数据库当成“验真工具”
那是不是北大法宝这类外部大型数据库就彻底没有用了?
当然有用,但绝不是让大模型在里面“漫游思考”,而是把它当作一个确定性校验的接口。
通过模型上下文协议(MCP),把专业数据库做成一个核验插件:
- 当 Agent 引用了一条法规时,触发接口查询:“这部行政法规当前是否现行有效?近期是否有最新修正案?”
- 当文书里提及一个指导性案例时,触发接口校验:“该案裁判要旨的核心表述是否准确?是否已被最新指导意见取代?”
让外部大库干它最擅长的事——做条文有效性与案号真实性的查漏补缺;而把核心的法理推演和尺度把控,牢牢锁在你的私有权威库里。
这才是既尊重计算机工程规律、又契合法律职业理性的正道。
四、结语:沉淀规则和数据,才是律师真正的护城河
技术厂商为了讲商业故事,永远倾向于把产品包装得“大而全”。因为“全量数据”在宣传册上看起来震撼,收费也更有底气。
但作为最终在文书上签名担责的法律人,我们必须保持技术的清醒。
大模型本身并不懂法律,它只是在给定的上下文里寻找概率上最合理的表达。你喂给它大海,它还你泥沙;你喂给它金矿,它才能为你淬炼出纯金。
在 AI 时代,比拥有海量数据更珍贵的,是识别数据权重的专业眼光,以及把这些权重转化为机器规则的手艺。
少去迷信那些动辄“全量”的营销噱头。花点心思,把你团队十年积累的实务尺度沉淀成一份小巧而权威的私有库,配上一套可靠的核验机制。
这才是任何套壳厂商都无法复制、同行也无法轻易抄袭的真正壁垒。
作者简介: 陈石律师(主页 chenshi.ai),浙江海泰律师事务所副主任、高级合伙人、房地产与建设工程部主任,第十届宁波市律师协会常务理事、第七届宁波仲裁委员会仲裁员,聚焦建筑房地产、投融资、并购重组及商事争议解决。曾获多家法律媒体与专业机构认可,荣登 LegalOne 2025 中国区建工及房地产实务先锋 45 强、律新社 2025 年度管理合伙人 20 佳(华东),入选《商法》The A-List 法律精英,获评 ALB China 区域市场十五佳长三角地区律师新星,并获律新社 2024 年度并购领域品牌之星。长期为万科、华润置地、信达地产、保利置业、招商蛇口、中海地产等企业提供法律服务,承办“首宗百亿地王”“长春第一高楼”“台州第一高楼”等代表性项目,累计服务项目投资额超千亿。近年来持续推动 AI 与法律实务融合,强调以结构化方法打通技术逻辑、法律判断与商业场景;著有《赋能法律人:AI 底层思维与应用范式》,并在多地开展相关主题讲座与分享。