一份AI榜单,如果按访问量排,读到的是人们去哪里;如果按消费支出排,读到的是人们把钱留在哪里。两张榜单未必讲同一个故事。
a16z第七版消费AI榜单增加美国消费者观察支出后,出现了一个值得停下来看一眼的数字:支出榜前50个供应商中,有29个没有出现在其web或mobile榜上。Olivia Moore原文
这个差异让“流量大,所以价值高”的直觉需要重新检查。它也容易被读成另一个过度结论:“垂直AI已经全面胜出。”两张榜都没有提供这种证明。
我想把问题放到专业服务里。设想一个团队明天要开会,桌上缺的是材料缺口、出处位置和仍待判断的问题。一个长答案、一套能反复运行的工作流程、一份经专业人员复核后可使用的材料,可能对应不同的购买理由。
榜单给出了支付行为的线索。专业服务怎样接住这种线索,仍要靠自己的交付来验证。
一、29家榜单外公司,说明观察窗口变了
这版榜单的web部分使用Similarweb月访问量,mobile部分使用Sensor Tower月活跃用户;消费支出则来自YipitData的美国面板观察。主web/mobile榜的数据期为2026年8月。
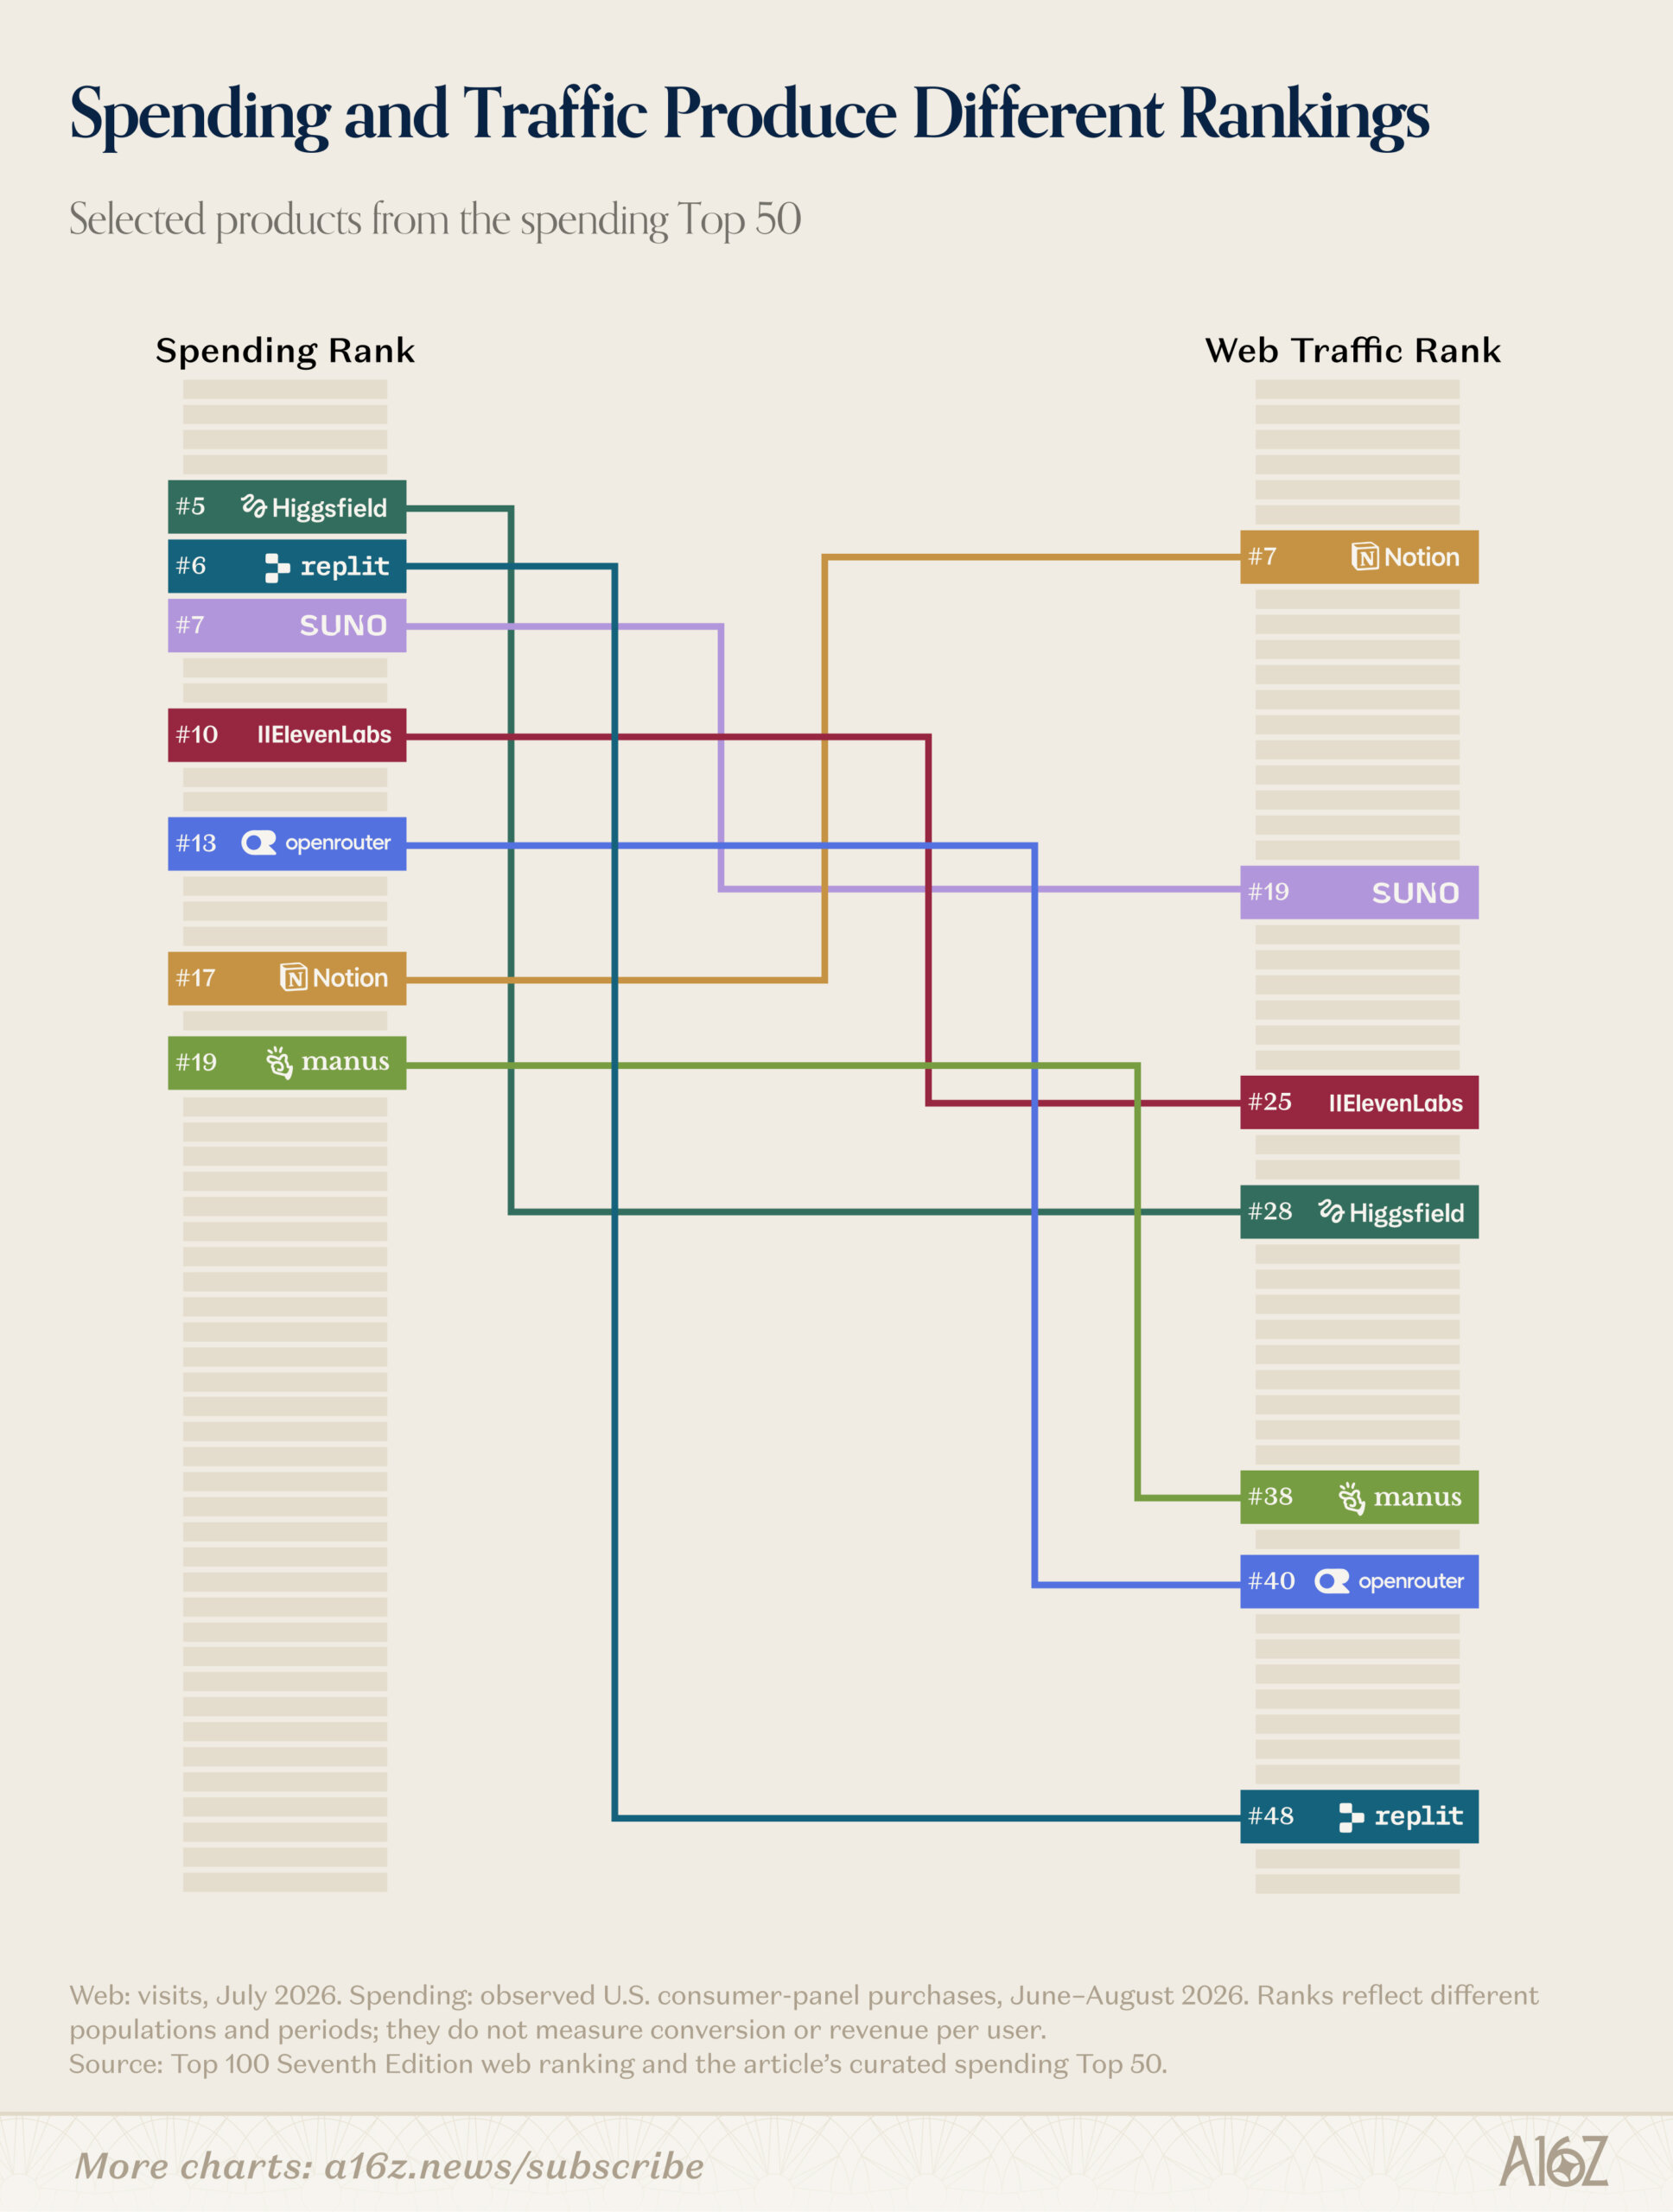
图源:a16z第七版消费AI榜单。此张比较图的web数据为2026年7月,消费支出为6—8月,与主榜时间不同;图中为选取的排名条目,不展示全部29家榜外公司。两侧观察人群不同,不能计算转化率或ARPU(每用户平均收入)。原图
访问量、活跃用户和消费支出分别适合回答不同问题。一个产品可能通过桌面客户端使用,也可能进入既有消息平台,网站访问量未必充分反映使用。一个人可能每月稳定付费,却不需要每天打开网页。另一个产品访问频繁,也未必在这组美国个人支付记录里表现突出。
这些都是可能产生排名差异的机制,不是对29个供应商逐一核验后的归因。没有进入流量前50,也不表示它们没有流量;排进消费支出前50,也不表示它们已经盈利。
消费支出不能当作公司的全球营收。企业采购、其他地区支付、不同付费渠道,以及公司的成本,都不在这张排名里得到完整说明。报告还因无法从Google收入中拆分相应支付而排除了Gemini的支出排名;这不能解释为它的付费表现弱。
更需要克制的是时间的拼接。主榜是8月,这张支出与流量比较图采用了不同期间。把图上一个排名变化解释成“同一批访问者后来付费”,已经加入了材料没有提供的用户追踪。
对我而言,29这个数字的意义是提醒研究者多开一扇观察窗口。流量榜适合发现普及程度,支出榜让某些购买行为可见。真正想判断一个专业产品,还需要问清楚它服务了什么任务,谁在付钱,谁实际接受成果。
二、从购买对象出发,分清三种价值
这里可以提出一个分析框架:人们购买的,可能是通用智能的入口、反复任务的工作流程,或经专业核验的成果。这是我的分类建议,不是a16z的统计分组;同一个产品也可能提供其中几项。
购买通用智能入口,得到的是较宽的能力范围。用户自己组织材料,说明要求,再处理输出。它适合愿意探索、能够管理工作过程的人。若任务相对简单,一个入口就可能足够,没有理由默认必须购买行业专用产品。
购买工作流程,期待的是减少重复组织。材料怎样进入,哪些步骤先做,哪些结果保留,什么时候交给人检查,都成为产品的一部分。判断价值时,就应检查规则是否稳定、异常能否被识别、上下文是否方便维护。
购买专业成果,则会进一步问:这份材料可用于什么,依据在哪里,哪些内容经过复核,哪些判断仍然保留条件。专业人员承担的分析和核验工作,会影响交付的内容、边界和成本。
这种区分没有给三者排高低。专业服务机构若把原本可以由通用工具完成的简单任务包装得很贵,使用者当然有理由拒绝。流程若只是把几个提示词连起来,却没有处理材料差异和例外,长期使用也可能暴露出很多额外工作。
相反,一个范围很窄的流程,若每次都能保留出处、标出缺口,并减少团队重复整理,可能比一个声称包办全部问题的入口更容易被评估。它是否值得付费,仍须看真实使用和成本,不能从榜单排名借来答案。
三、律师的增量,要体现在交付物里
Olivia Moore在报告中讨论了几类产品机会:围绕任务使用多模型、服务有特定需要的受众、改变既有交互方式。它们是投资机构作者对机会的判断,可以启发产品设计,不能替代中国专业服务市场的需求调查。
从律师的工作角度,我更愿意把这些机会翻译成几项具体要求。先看材料是否齐备。提交了一组文件,不意味着问题所需的材料已经齐全。成果应该能说明缺什么、为什么这项缺口可能影响后续分析,并避免悄悄用模型猜测补上事实。
事实追溯也需要进入交付。把结论放在页面中央很容易,把结论对应的材料位置保留下来,才方便另一位专业人员检查。来源是否明确、时间是否一致、统计口径是否被改变,都可能影响结果能否进入讨论。
接着看分歧与判断位置。即使整理得很完整,材料也可能互相矛盾,某些问题仍取决于尚未确认的事实。成果应让人看到支持与反对的依据,把需要判断的位置显露出来。看起来毫无疑问的长答案,有时只是把分歧藏掉了。
交付用途也要说明。供内部学习的摘要,与供负责人据以作出下一步决定的材料,验收要求并不相同。专业服务应说明成果当前适合做什么,哪些部分还不能直接使用,让接收者知道自己还要承担哪一段工作。
这几项要求都能在公开材料任务中演示,无需先展示客户项目。比如,为一组公开行业报告制作材料清单、来源定位和问题表。读者可以检查它有没有帮助,也可以指出遗漏。这里讨论的是可以设计与验证的交付形式,没有声称某个平台已经实现,或某家机构已经取得收入。
把专业判断进入工作过程的位置写清楚,才容易继续谈工具怎样配合。某一段可以由模型反复完成,某一段需要人逐项核查,还有一段需要负责律师根据事实作出判断。每一段的成本与责任不同,产品设计需要尊重这些差异。
四、一个窄任务,足以开始检验付费价值
若要继续验证,我会先选一个使用者能具体描述的任务:发生在什么场景,现有做法最费力的环节是什么,需要什么形式的材料。先让范围清楚,再决定是否值得做工具。
拿公开材料试行时,固定材料版本和目标,保留人工复核后的结果,也留下被弃用的输出。观察准备和返工是否减少,出处是否更容易定位,使用者是否还要把整份成果重新组织一遍。不能只凭生成速度宣称节省成本。
随后再问交付形式。例如,使用者更需要一页问题表,还是可以不断补充的材料目录?一个人觉得完整,接收的人却无法快速使用,这样的成果仍有改进空间。专业服务的价值要在交接时接受检查,不能只在展示时成立。
愿意使用与愿意付费也需要分开。免费试用中得到好评,只能提供体验线索;付费意愿、可接受价格、持续使用频率,仍须另做验证。报价和真实续用还可能得到不同的答案。本文没有这些中国本地证据,因此不会从29个供应商推导出律师行业的付费规模。
专业服务中,出钱的人、操作工具的人和接收成果的人,还可能不是同一个人。操作的人觉得顺手,接收的人可能仍要重新核查;接收的人觉得结果有用,预算负责人还要看持续成本。试行时应分别听取这些意见,弄清楚价值出现在哪个环节,以及谁需要承担新增工作。一个人的好评,不能替整条交付关系作决定。
也要给通用工具留下位置。如果使用者自己就能以较低成本完成任务,专业产品需要说明额外提供了什么。若增量暂时不清楚,可以继续改进,也可以放弃这个方向。专业标签不会自动产生购买理由。
流量榜之外有值得研究的支付行为。对专业服务机构而言,下一步可做的事,是把一项交付的材料、依据、核验和用途写清楚,再让实际使用者判断:这份成果是否值得留在自己的工作里。
资料说明: 依据Olivia Moore于2026年10月5日发布的《Top 100 Consumer AI Apps — Seventh Edition》及官网同文。两个网页为同一篇文章。流量、活跃使用与美国消费支出不是同一统计对象。三种购买对象及专业交付要求为本文分析建议,不构成中国市场规模、产品成熟度或收入判断。
作者简介: 陈石律师(主页 chenshi.ai),浙江海泰律师事务所副主任、高级合伙人、房地产与建设工程部主任,第十届宁波市律师协会常务理事、第七届宁波仲裁委员会仲裁员,聚焦建筑房地产、投融资、并购重组及商事争议解决。曾获多家法律媒体与专业机构认可,荣登 LegalOne 2025 中国区建工及房地产实务先锋 45 强、律新社 2025 年度管理合伙人 20 佳(华东),入选《商法》The A-List 法律精英,获评 ALB China 区域市场十五佳长三角地区律师新星,并获律新社 2024 年度并购领域品牌之星。长期为万科、华润置地、信达地产、保利置业、招商蛇口、中海地产等企业提供法律服务,承办“首宗百亿地王”“长春第一高楼”“台州第一高楼”等代表性项目,累计服务项目投资额超千亿。近年来持续推动 AI 与法律实务融合,强调以结构化方法打通技术逻辑、法律判断与商业场景;著有《赋能法律人:AI 底层思维与应用范式》,并在多地开展相关主题讲座与分享。